Home›Tags›#qwen

Tag timeline

#qwen23 total

同じキーワードで束ねられた更新を確認できます。カテゴリをまたいだ関連ニュースや実装トピックの追跡に使えます。

Total23#qwen の全掲載記事All listed entries tagged #qwen
Showing23このページの件数Entries on this page
Page1/1静的ページ位置Static page position
Updated一覧の更新時刻List last updated

Entriespage 1/1 · 23 total

10/5(月)Mon, Oct 51 entries
コミュニティCommunityLocal Models·Simon Willison's Weblog

Qwen3.8 27Bによる足し算の文章回答Qwen3.8 27B addition in words

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約Qwen3.8 27Bは、大きくなる数の足し算を行い、答えを数字ではなく言葉で返す試験をDGX Spark上で実施した。管理されたローカル環境でGPT-4oとの計算能力を比較できる。

AI SUMMARYQwen3.8 27B was tested on increasingly large additions while spelling out each result, using a Q4_K_M GGUF on DGX Spark. This enables a controlled local comparison with GPT-4o.
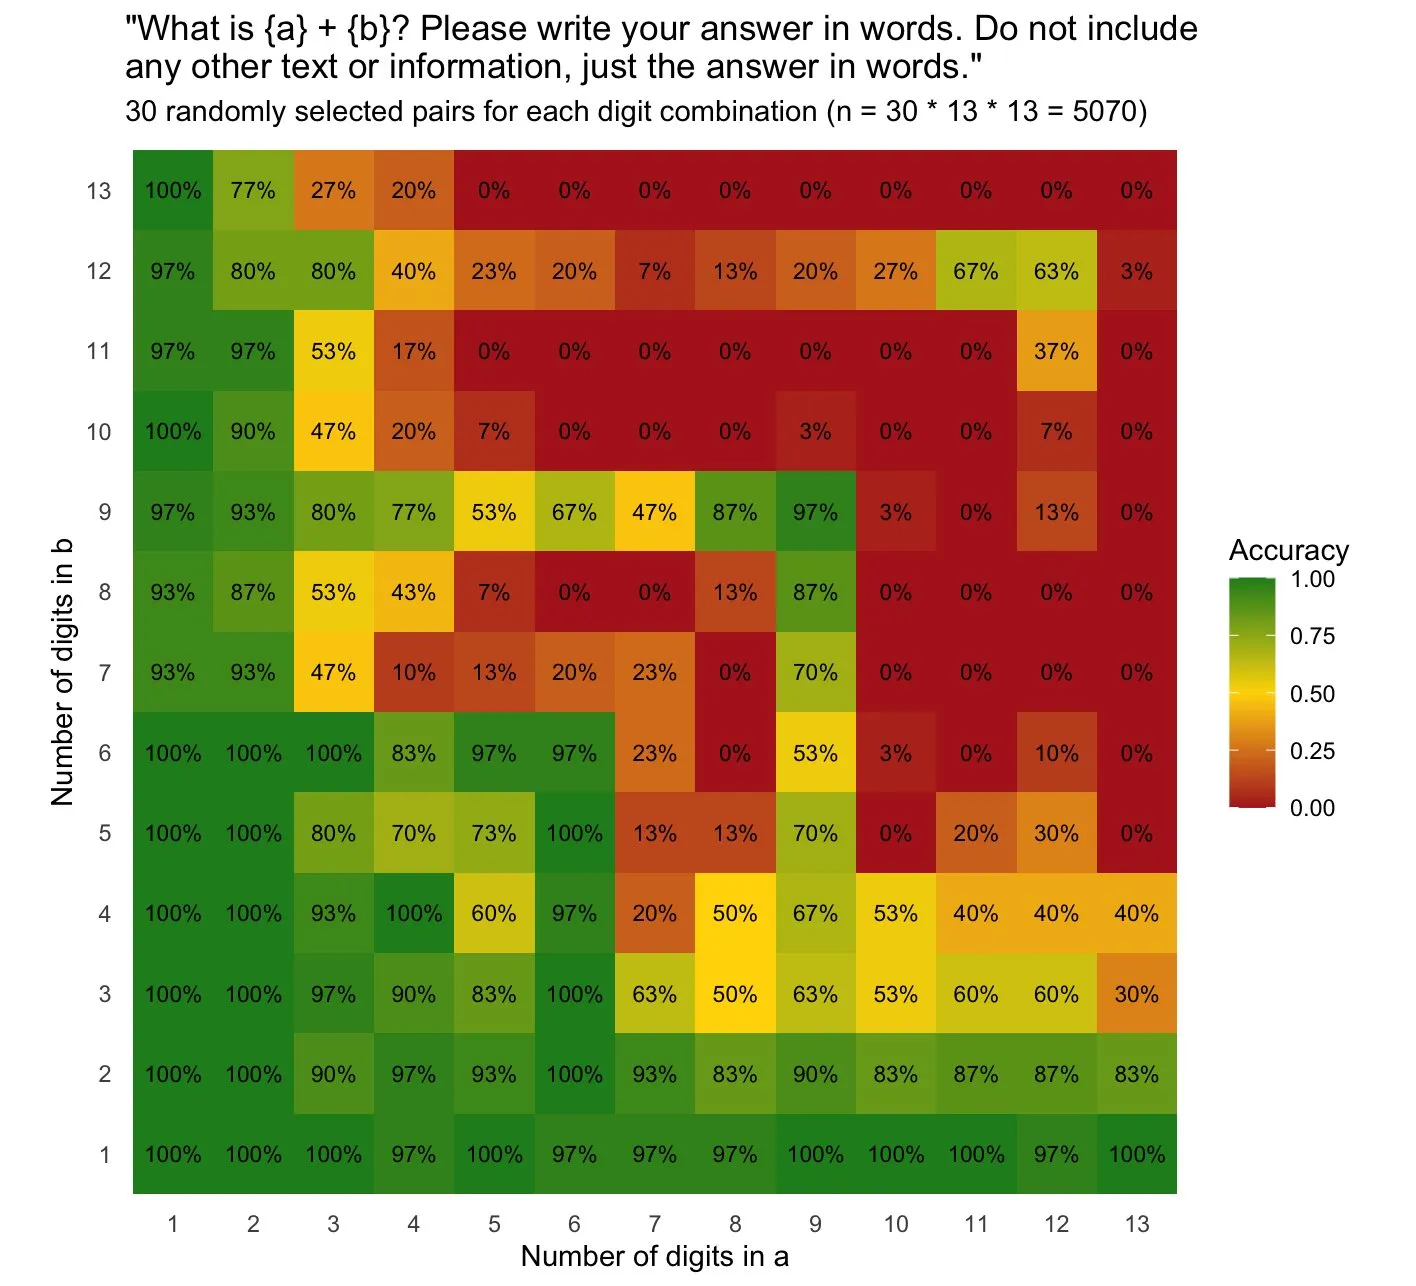
Qwen3.8 27B addition in words
8/27(木)Thu, Aug 274 entries
公式OfficialLocal Models·Ollama Releases

Ollama v0.33.1がリリースOllama Releases v0.33.1

重要度 InfoInformational深掘り候補 · 公式リリース · Local LLM / Open ModelsDeep-dive candidate · official release · Local LLM / Open Models

AI要約Ollama v0.33.1は、MLXでQwen3.8 Flash Nextに対応し、mlxrunnerに構造化出力と低速ストレージ利用時のMetal GPUタイムアウト対策を追加しました。ローカルLLM利用者の互換性と安定性が向上します。

AI SUMMARYOllama v0.33.1 adds MLX support for Qwen3.8 Flash Next, structured output in mlxrunner, and a Metal GPU timeout fix for slow storage, benefiting local LLM users.

Ollama Releases v0.33.1
コミュニティCommunityLocal Models·Simon Willison's Weblog

Qwen3.8-Flash-Next:Qwen4アーキテクチャのプレビューとなるマルチモーダルMoEモデルQwen3.8-Flash-Next

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約QwenがQwen4の設計を先行公開するマルチモーダルMoEモデル「Qwen3.8-Flash-Next」をリリース。総パラメータ125Bながらアクティブは6Bのみで、高い推論効率を実現している。

AI SUMMARYQwen3.8-Flash-Next is a multimodal MoE model previewing the Qwen4 architecture, with 125B total parameters but only 6B active at inference time, delivering strong performance at low computational cost.

Qwen3.8-Flash-Next
公式OfficialLocal Models·Ollama Releases

Ollama v0.33.1-rc1 リリースv0.33.1-rc1: linux: fix llama.cpp docker build (#18040)

重要度 InfoInformational深掘り候補 · 公式リリース · Local LLM / Open ModelsDeep-dive candidate · official release · Local LLM / Open Models

AI要約Ollama v0.33.1では、MLXランナーに構造化出力サポートと低速ストレージ時のMetal GPUタイムアウト回避が追加され、Qwen3.8 Flash Nextへの対応も加わった。

AI SUMMARYOllama v0.33.1 adds structured output support and Metal GPU timeout fixes to the MLX runner, alongside Qwen3.8 Flash Next support and llama.cpp updates.

v0.33.1-rc1: linux: fix llama.cpp docker build (#18040)
公式OfficialLocal Models·Ollama Releases

v0.33.1-rc0: MLX で「Qwen3.8 Flash Next」サポートを追加v0.33.1-rc0: MLX: Qwen3.8 Flash Next support (#18032)

重要度 InfoInformational深掘り候補 · 公式リリース · Local LLM / Open ModelsDeep-dive candidate · official release · Local LLM / Open Models

AI要約Ollama v0.33.1-rc0 がリリースされ、MLX バックエンドで Qwen3.8 Flash Next モデルのサポートが追加された。Apple Silicon 環境でのモデル選択肢が広がる。

AI SUMMARYOllama v0.33.1-rc0 adds MLX backend support for the Qwen3.8 Flash Next model, expanding the range of models available for efficient inference on Apple Silicon hardware.

v0.33.1-rc0: MLX: Qwen3.8 Flash Next support (#18032)
8/24(月)Mon, Aug 241 entries
コミュニティCommunityLocal Models·Qiita LLM

【ローカルLLM】国産LLM「LLM-jp-4-33B」と「Qwen3.8-27B」の推論性能比較(RTX 5070 Ti + RTX 3070 Ti)A hands-on benchmark comparing the newly released Japanese LLM "LLM-jp-4 33B"…

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約LLMCが公開した約332億パラメーターのDense型モデル「LLM-jp-4 33B」を、RTX 5070 TiとRTX 3070 Tiの2枚構成でローカル実行し、Qwen3.8-27Bとの推論性能を比較検証した記事。

AI SUMMARYA hands-on benchmark comparing the newly released Japanese LLM "LLM-jp-4 33B" (a 33B Dense model) against Qwen3.8-27B, run locally on a dual-GPU setup of RTX 5070 Ti and RTX 3070 Ti.

【ローカルLLM】国産LLM「LLM-jp-4-33B」と「Qwen3.8-27B」の推論性能比較(RTX 5070 Ti + RTX 3070 Ti)
8/20(木)Thu, Aug 202 entries
コミュニティCommunityLocal Models·Qiita LLM

RTX 4070で90日連続稼働したローカルLLMの電気代を気温別に測った — 夏と冬で電気代が2倍違ったA 90-day continuous run of Qwen 35B on an RTX 4070 home workstation revealed…

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約RTX 4070にQwen 35Bを載せた自宅ワークステーションを90日間24時間稼働させ、気温別・タスク別に電気代を計測した結果、夏季と冬季で最大2倍の差が生じることが判明した。

AI SUMMARYA 90-day continuous run of Qwen 35B on an RTX 4070 home workstation revealed that ambient temperature doubles electricity costs between summer and winter, offering rare real-world data for local LLM operators.

RTX 4070で90日連続稼働したローカルLLMの電気代を気温別に測った — 夏と冬で電気代が2倍違った
コミュニティCommunityLocal Models·Qiita LLM

Alibabaオープンモデルの現在地を整理。半年で30億DL・派生30万・Qwen3.8-27BはApache 2.0Alibaba's Qwen open models reached 3 billion downloads across all platforms in…

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約AlibabaのQwenシリーズは直近6か月で全プラットフォーム合計30億ダウンロードを達成し、派生モデルも30万を超えた。Qwen3の8B〜27BモデルにはApache 2.0ライセンスが適用され、商用・研究用途での利用障壁が大きく下がっている。

AI SUMMARYAlibaba's Qwen open models reached 3 billion downloads across all platforms in six months, with over 300,000 derivative models created. Qwen3 models ranging from 8B to 27B parameters are released under Apache 2.0, significantly lowering barriers for commercial and research use.

Alibabaオープンモデルの現在地を整理。半年で30億DL・派生30万・Qwen3.8-27BはApache 2.0
8/18(火)Tue, Aug 181 entries
コミュニティCommunityLocal Models·Simon Willison's Weblog

Qwen 3.8 27BがArtificial Analysis Intelligence Indexでスコア52を達成Qwen 3.8 27B scores 52 on the Artificial Analysis Intelligence Index

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約27BパラメータのQwen 3.8 27BがGPT-5.6 Lunaと同スコア52を記録し、753BのGLMや1.6TのDeepSeek V4 Proとほぼ同等の性能を示した。小規模モデルがはるかに大きなモデルと肩を並べた点が注目される。

AI SUMMARYQwen 3.8 27B achieved a score of 52 on the Artificial Analysis Intelligence Index, matching GPT-5.6 Luna and nearly tying the 753B GLM-5.2 and 1.6T DeepSeek V4 Pro, highlighting strong efficiency at a much smaller parameter count.

8/17(月)Mon, Aug 171 entries
コミュニティCommunityLocal Models·Simon Willison's Weblog

Qwen 3.8 27Bは優秀だが、デフォルトで過剰な思考をするQwen 3.8 27B is excellent, but it defaults to wildly overthinking things

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約AlibabaのQwen研究室がApache 2ライセンスのビジョン対応27Bモデル「Qwen 3.8 27B」をリリース。ラップトップで動作する優れたサイズだが、デフォルトで過剰な推論を行う傾向がある点に注意が必要。

AI SUMMARYAlibaba's Qwen lab released Qwen 3.8 27B, an Apache 2 licensed vision-capable model well-suited for laptop inference, though its tendency to overthink by default is a notable caveat for practical use.

Qwen 3.8 27B is excellent, but it defaults to wildly overthinking things
8/16(日)Sun, Aug 163 entries
コミュニティCommunityLocal Models·Zenn LLM

Qwen3.8 27B に Reasoning Effort を実装してみるThe author resolved Qwen3.8 27B's tendency to over-think on ambiguous tasks by…

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約Qwen3.8 27Bで思考が長引き生成上限に達する問題を、llama.cppのPer-request reasoning budgetで強制打ち切りすることで解消し、曖昧なタスクでも自律的に完走できるようになった。

AI SUMMARYThe author resolved Qwen3.8 27B's tendency to over-think on ambiguous tasks by enabling per-request reasoning budget in llama.cpp, allowing the model to complete complex tasks like Minecraft clone creation autonomously without hitting generation limits.

Qwen3.8 27B に Reasoning Effort を実装してみる
コミュニティCommunityLocal Models·Qiita LLM

RTX 4070 Ti SUPER 16GBでQwen3.8-27Bを動かしてみた ― OpenCodeは16Kで止まり、32KでWebアプリを完遂したA hands-on report running Qwen3.8-27B locally on an RTX 4070 Ti SUPER 16 GB GPU…

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約Ubuntu搭載の自宅PCでQwen3.8-27BをローカルLLMとして稼働させ、コーディングエージェントOpenCodeを使ったWebアプリ生成をコンテキスト長16Kと32Kで比較検証した結果、32Kでのみ完走できることが確認された。

AI SUMMARYA hands-on report running Qwen3.8-27B locally on an RTX 4070 Ti SUPER 16 GB GPU shows that the OpenCode coding agent fails to complete a web-app task at a 16 K context window but succeeds at 32 K, offering practical guidance for consumer-GPU LLM setups.

RTX 4070 Ti SUPER 16GBでQwen3.8-27Bを動かしてみた ― OpenCodeは16Kで止まり、32KでWebアプリを完遂した
コミュニティCommunityLocal Models·Qiita LLM

Qwen3.8-27B は MoE ではなかった — ローカル音声対話AIへの採用を30回計測して見送るまでThe author evaluated replacing Qwen3.6-35B-A3B (MoE) with Qwen3.8-27B in a…

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約Ryzen AI MAX+ 395環境のローカル音声対話AIで、MoEモデルのQwen3.6-35B-A3BからQwen3.8-27Bへの乗り替えを検討したが、27Bがdense modelであると判明し、速度・品質の計測30回の結果として採用を見送った。

AI SUMMARYThe author evaluated replacing Qwen3.6-35B-A3B (MoE) with Qwen3.8-27B in a fully local voice-dialogue AI on Ryzen AI MAX+ 395, but after 30 benchmark runs discovered the 27B is a dense model and ultimately decided against the switch.

Qwen3.8-27B は MoE ではなかった — ローカル音声対話AIへの採用を30回計測して見送るまで
8/15(土)Sat, Aug 151 entries
コミュニティCommunityLocal Models·Simon Willison's Weblog

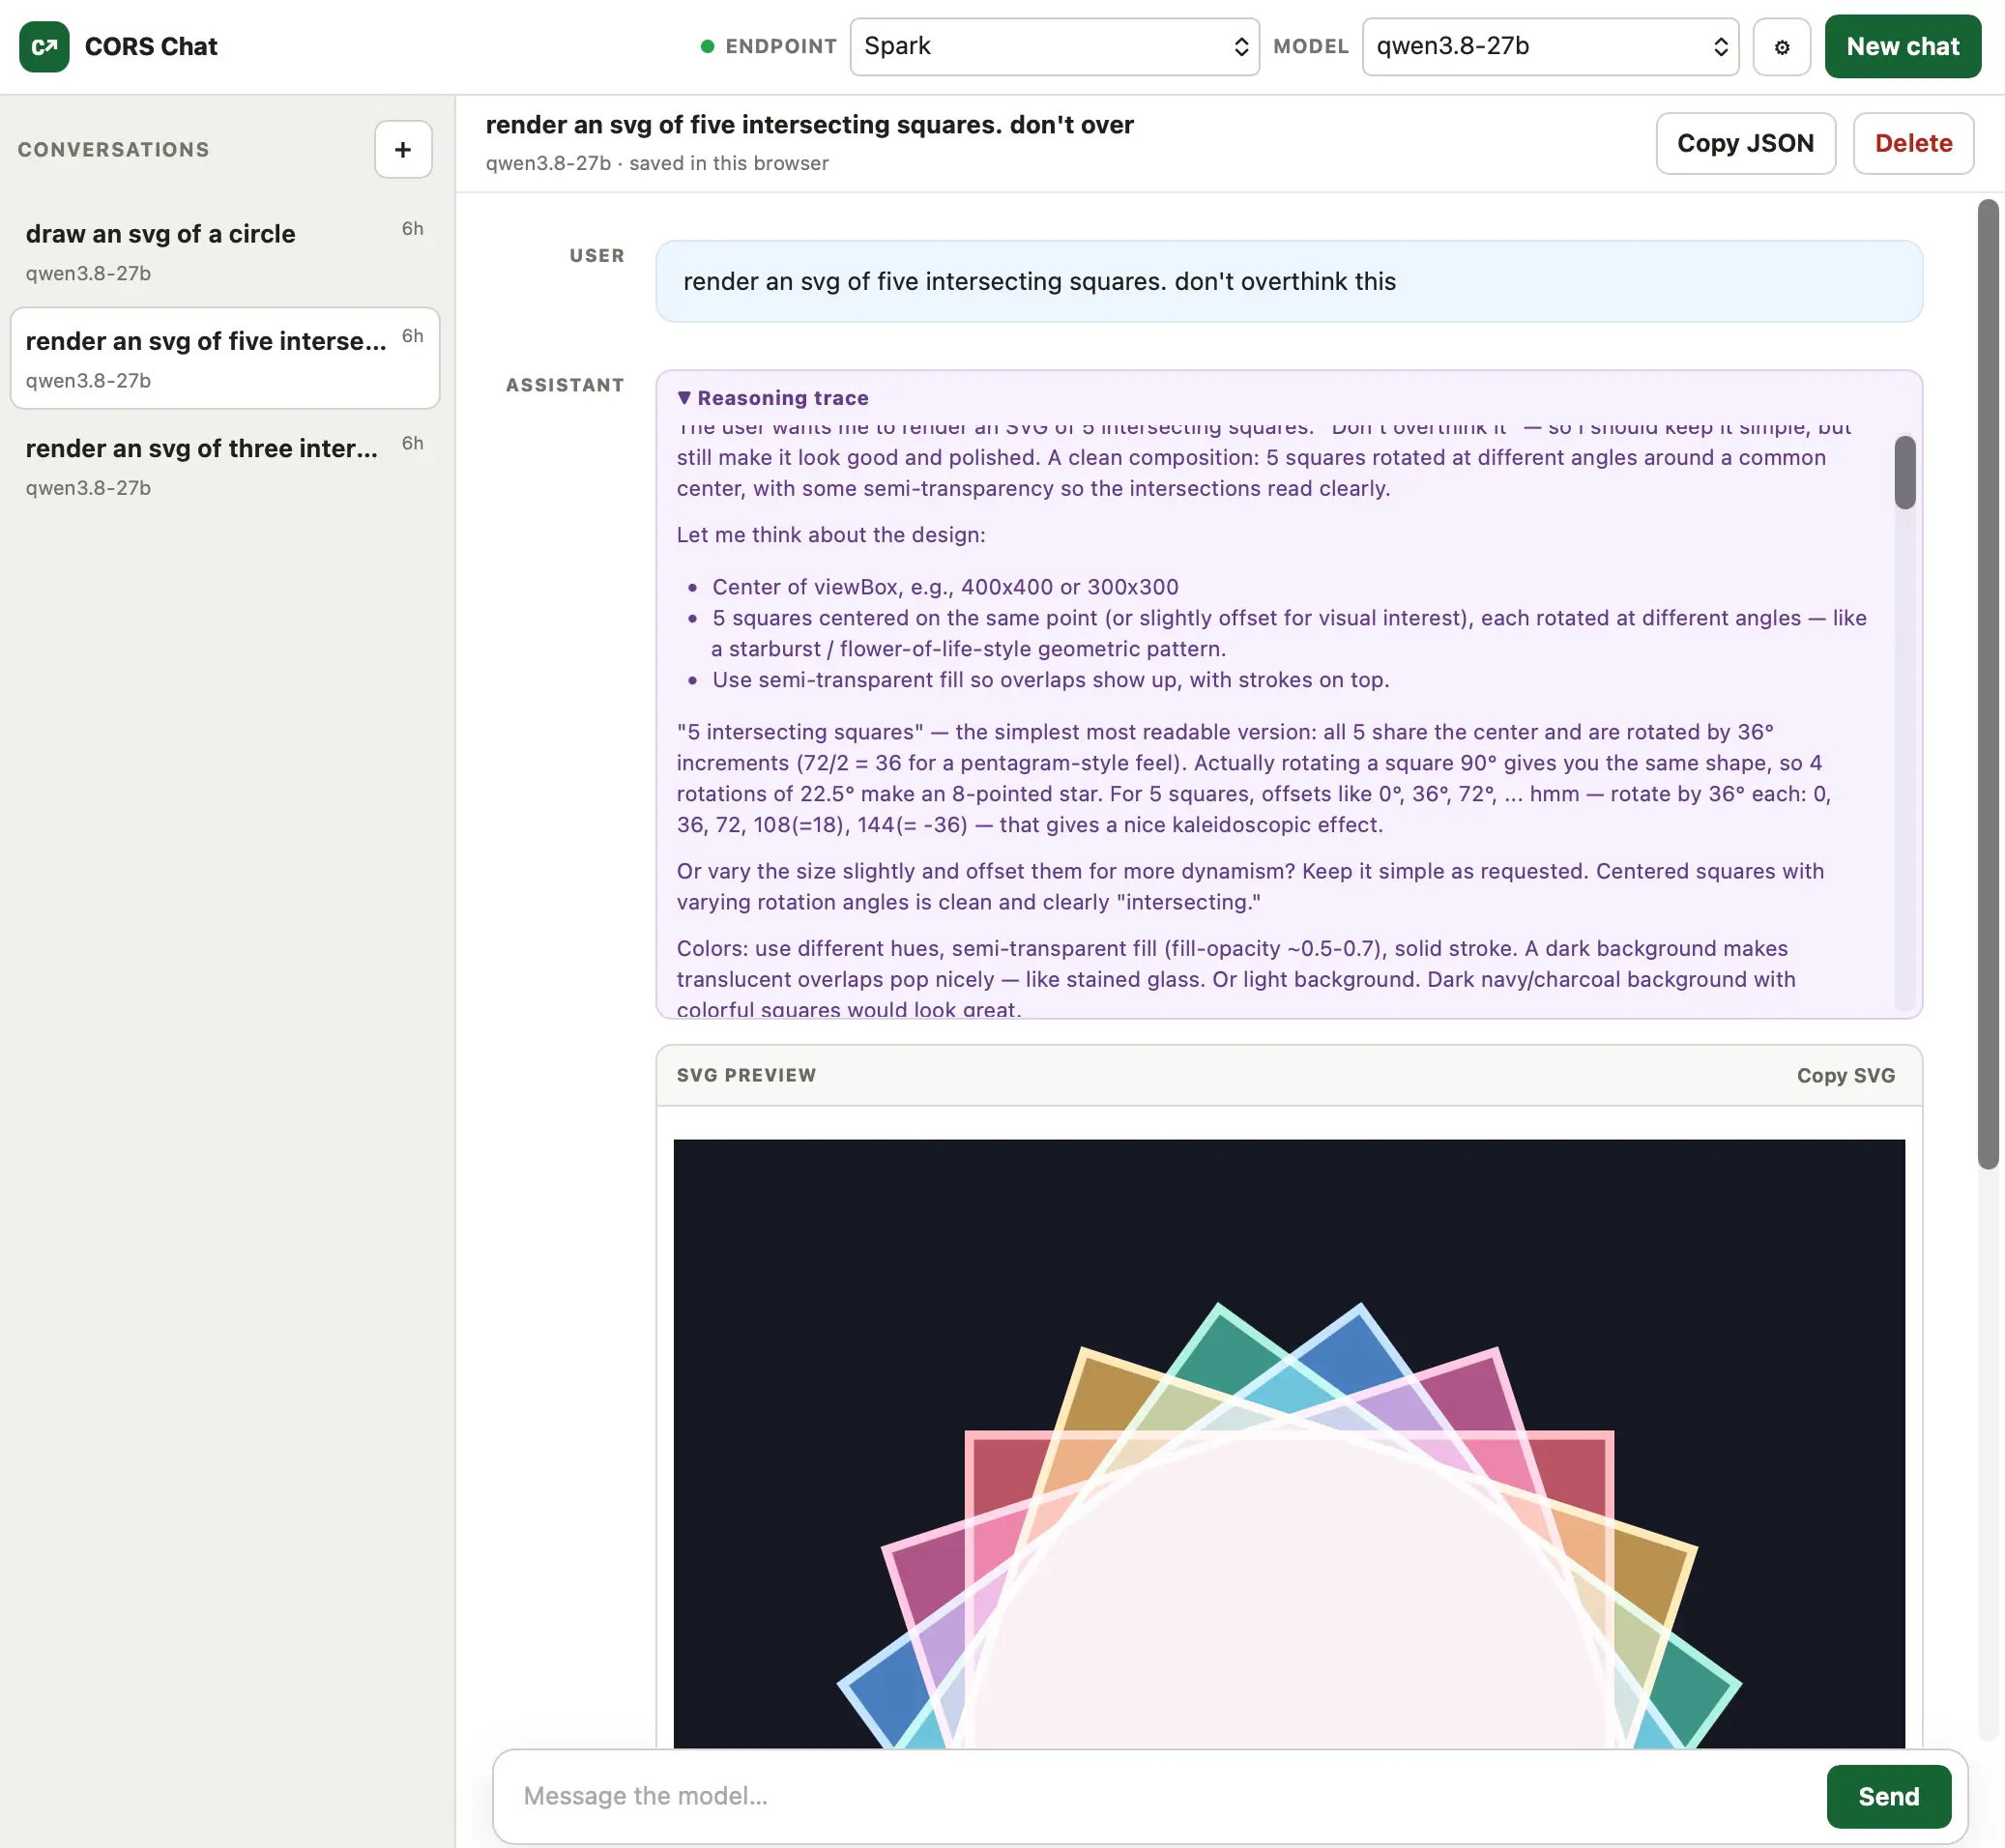
ローカルLLM検証用Web UI「CORS Chat」を公開CORS Chat

重要度 InfoInformational深掘り候補 · 技術記事 · Local LLM / Open ModelsDeep-dive candidate · technical post · Local LLM / Open Models

AI要約CORS ChatはOpenAI Responses形式のチャットAPIを操作できるWeb UIとして公開され、LM Studio上のQwen 3.8 27BをM5 MacBook ProとNVIDIA DGX Sparkで試す開発者のローカルLLM検証を容易にする。

AI SUMMARYCORS Chat adds a browser UI for OpenAI Responses-style chat APIs, tested with Qwen 3.8 27B in LM Studio on an M5 MacBook Pro and NVIDIA DGX Spark, easing local LLM checks.

CORS Chat
8/13(木)Thu, Aug 131 entries
コミュニティCommunityLocal Models·Qiita LLM

RTX 4090 × 4枚で Qwen3.6-27B ファインチューン「Fable-Fusion-711」を vLLM (Docker) で動かす — ハイブリッド構成の KV 設計までThis article walks through running the Qwen3.6-27B community fine-tune…

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約DavidAU 氏による Qwen3.6-27B のコミュニティファインチューン「Fable-Fusion-711」を、RTX 4090 4枚構成で vLLM (Docker) を使って実行する手順と、ハイブリッド構成向けの KV キャッシュ設計を解説した記事です。

AI SUMMARYThis article walks through running the Qwen3.6-27B community fine-tune "Fable-Fusion-711" — which outperforms the base model on 6 of 7 benchmarks including ARC-C — on a four-GPU RTX 4090 setup via vLLM in Docker, covering KV cache design for hybrid configurations.

RTX 4090 × 4枚で Qwen3.6-27B ファインチューン「Fable-Fusion-711」を vLLM (Docker) で動かす — ハイブリッド構成の KV 設計まで
8/6(木)Thu, Aug 61 entries
🔥 HOTコミュニティCommunityLocal Models·Zenn AI

AlibabaのQwen3.8-Maxは2.4兆パラメータのオープンウェイトMoEモデル——その実態と活用法Qwen3.8-Max Is Alibaba's Biggest Open-Weight Bet Yet. Here's What You

重要度 HighHigh priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約Alibabaが2.4兆パラメータのMoEモデルQwen3.8-Maxをオープンウェイトで公開予定と発表し、ベンチマーク性能やClaude Codeでの実行方法が解説されている。

AI SUMMARYAlibaba announced Qwen3.8-Max, a 2.4-trillion-parameter MoE model set to go open-weight, with a breakdown of benchmark results and instructions for running it via Claude Code.

Qwen3.8-Max Is Alibaba's Biggest Open-Weight Bet Yet. Here's What You
8/2(日)Sun, Aug 23 entries
コミュニティCommunityLocal Models·Zenn LLM

Qwen3.5-9B(Q4/6.6GB)にM1 Maxで日本語を書かせたら、答えは131字なのに出力は3936トークンだったHands-on testing of Qwen3.5-9B (Q4, 6.6 GB) on an M1 Max revealed that a…

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約M1 Max 64GBでQwen3.5-9B Q4量子化モデルを実測したところ、短い日本語回答に対して数千トークンの過剰出力が発生し、「GPT-4超え」の主張は実環境では検証困難であることが示された。

AI SUMMARYHands-on testing of Qwen3.5-9B (Q4, 6.6 GB) on an M1 Max revealed that a 131-character Japanese answer ballooned to 3,936 tokens, exposing a significant verbosity issue and making the widely-circulated "beats GPT-4" claim impossible to verify under real conditions.

Qwen3.5-9B(Q4/6.6GB)にM1 Maxで日本語を書かせたら、答えは131字なのに出力は3936トークンだった
コミュニティCommunityLocal Models·Zenn LLM

Qwen 35Bの品質を7つの質問で採点したら、GPT-4に勝てるのは3領域だけだったA hands-on benchmark pitting locally-run Qwen 35B against GPT-4 across seven…

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約RTX 4070でQwen 35Bをローカル動作させ、7項目の質問で GPT-4と比較採点した結果、3領域では明確に優位に立てることが判明した。「賢いモデルほど汎用的」という常識とは別に、ローカルLLMが実用的に刺さる用途が存在することを示している。

AI SUMMARYA hands-on benchmark pitting locally-run Qwen 35B against GPT-4 across seven questions found that the open model wins in exactly three domains, challenging the assumption that local LLMs are purely for experimentation and highlighting specific practical use cases for consumer-grade GPUs.

Qwen 35Bの品質を7つの質問で採点したら、GPT-4に勝てるのは3領域だけだった
コミュニティCommunityLocal Models·Zenn LLM

【実測】あなたのGPUで動く最強ローカルLLM 2026年7月版 — VRAM階級別ベンチマークA practical benchmark guide selecting the best local LLM per VRAM tier (6 GB…

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約Apple M5 Pro 48GBでの実測値と公開一次ソースを組み合わせ、6GB〜大容量までのVRAM階級ごとに最適なローカルLLMモデルをQwen3.5シリーズ中心にまとめたベンチマーク記事。

AI SUMMARYA practical benchmark guide selecting the best local LLM per VRAM tier (6 GB and up), combining direct measurements on Apple M5 Pro 48 GB with cited third-party data, with Qwen3.5 models dominating the lower tiers.

【実測】あなたのGPUで動く最強ローカルLLM 2026年7月版 — VRAM階級別ベンチマーク
7/31(金)Fri, Jul 311 entries
コミュニティCommunityLocal Models·Qiita LLM

Qwen 35Bは平均42Wで動く — RTX 4070の消費電力プロファイルを推論中に4パターン実測Benchmark measurements of Qwen 35B running on an RTX 4070 show average GPU…

重要度 MediumMedium priority技術記事 · Local LLM / Open Modelstechnical post · Local LLM / Open Models

AI要約RTX 4070上でQwen 35Bを動作させた際の消費電力を実測した結果、デコード中の平均はわずか42Wで、ピーク時でも175Wにとどまることが確認された。ローカルLLM運用時の電力コスト見積もりに役立つ具体的なデータとして注目される。

AI SUMMARYBenchmark measurements of Qwen 35B running on an RTX 4070 show average GPU power of only 42 W during decode, with prompt-eval peaks reaching 175 W, well below the card's 200 W TGP. These real-world power profiles offer useful reference data for estimating electricity costs of local LLM deployments.

Qwen 35Bは平均42Wで動く — RTX 4070の消費電力プロファイルを推論中に4パターン実測
7/16(木)Thu, Jul 161 entries
🔥 HOT報道NewsNews/Policy·TechCrunch

Apple Intelligence、アリババのQwen AIと共に中国でのリリースが承認されるApple Intelligence approved for launch in China with Alibaba’s Qwen AI

重要度 HighHigh priority技術記事 · Industry & Policytechnical post · Industry & Policy

AI要約AppleはアリババのQwen AIを採用したApple Intelligenceを中国で展開する承認を取得した。規制の壁を越えたことで、巨大な中国市場へのAI機能提供が現実となる。

AI SUMMARYApple has received regulatory approval to launch Apple Intelligence in China using Alibaba's Qwen AI, marking a significant breakthrough that opens the world's largest smartphone market to Apple's AI features.

7/14(火)Tue, Jul 141 entries
公式OfficialGemini/Gemma·Google Developers Blog

システムエンジニアリング実践ガイド:Ironwood(TPU v7)上でのQwen 3.5-397B MoEの最適化Systems Engineering Playbook: Optimizing Qwen 3.5-397B MoE on Ironwood (TPU7x)

重要度 MediumMedium priority技術記事 · Gemini / Gemmatechnical post · Gemini / Gemma

AI要約GoogleがIronwood TPU上でQwen 3.5-397BのMoEモデルを効率的に動かすための最適化手法を公開。大規模オープンモデルをTPUで本番運用する際の実践的な知見を提供している。

AI SUMMARYGoogle published a detailed systems engineering guide for optimizing the Qwen 3.5-397B MoE model on Ironwood (TPU v7), offering practical techniques that help teams efficiently deploy large open-weight models on TPU infrastructure.

5/29(金)Fri, May 291 entries
公式OfficialCline/Roo·Cline Releases

Cline v3.86.0 リリースCline Releases v3.86.0

重要度 MediumMedium priority公式リリース · Cline / Rooofficial release · Cline / Roo

AI要約Cline v3.86.0がリリース。Claude Opus 4.8および Moonshot Kimi K2.6のサポートを追加し、Qwen 3.7 Maxのプロンプトキャッシュ表示も修正。

AI SUMMARYCline v3.86.0 adds Claude Opus 4.5 provider support with 1M-context variants, Moonshot Kimi K2.6 model support, and fixes prompt-cache display for Qwen 3.7 Max.

Cline Releases v3.86.0